Nieuw lineair attentiemodel Laplace 3B getest op gespecialiseerde hardware
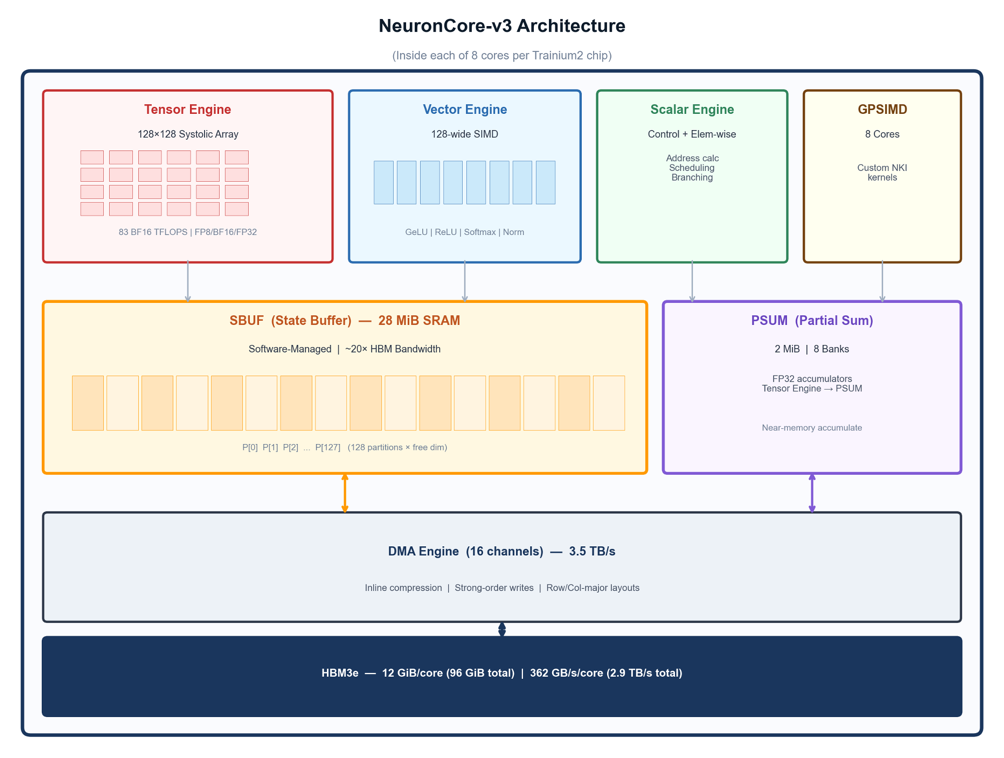
Het model Laplace 3B maakt gebruik van lineaire attentie en is getraind en gedraaid op speciale hardware met PyTorch. Dankzij een vaste geheugengrootte per sequentie wordt het groeiende geheugenprobleem van traditionele transformermodellen vermeden.
Ontwikkelaars hebben het Laplace 3B-model getraind en operationeel gemaakt op gespecialiseerde trainingschips met behulp van PyTorch. Dit model maakt gebruik van een lineaire attentietechniek waarbij de interne staat van de sequentie constant blijft, ongeacht de lengte van de context. Dit vormt een alternatief voor de traditionele key-value-caching die bij standaard transformermodellen gebruikelijk is.
Bij gangbare taalmodellen neemt het geheugengebruik voor de context doorgaans fors toe naarmate gesprekken of documenten langer worden. Door te kiezen voor een vaste geheugencapaciteit per sequentie blijft het benodigde geheugen voor het serveren van het model beter voorspelbaar. Dit soort architectonische aanpassingen zijn relevant voor het efficiënter inzetten van AI-systemen in de praktijk.
Deze samenvatting is gebaseerd op een origineel artikel van AWS Machine Learning. Lees het volledige, originele bericht bij de bron.
Lees het originele artikel