Optimalisatie van taalmodellen voor meertalig redeneren
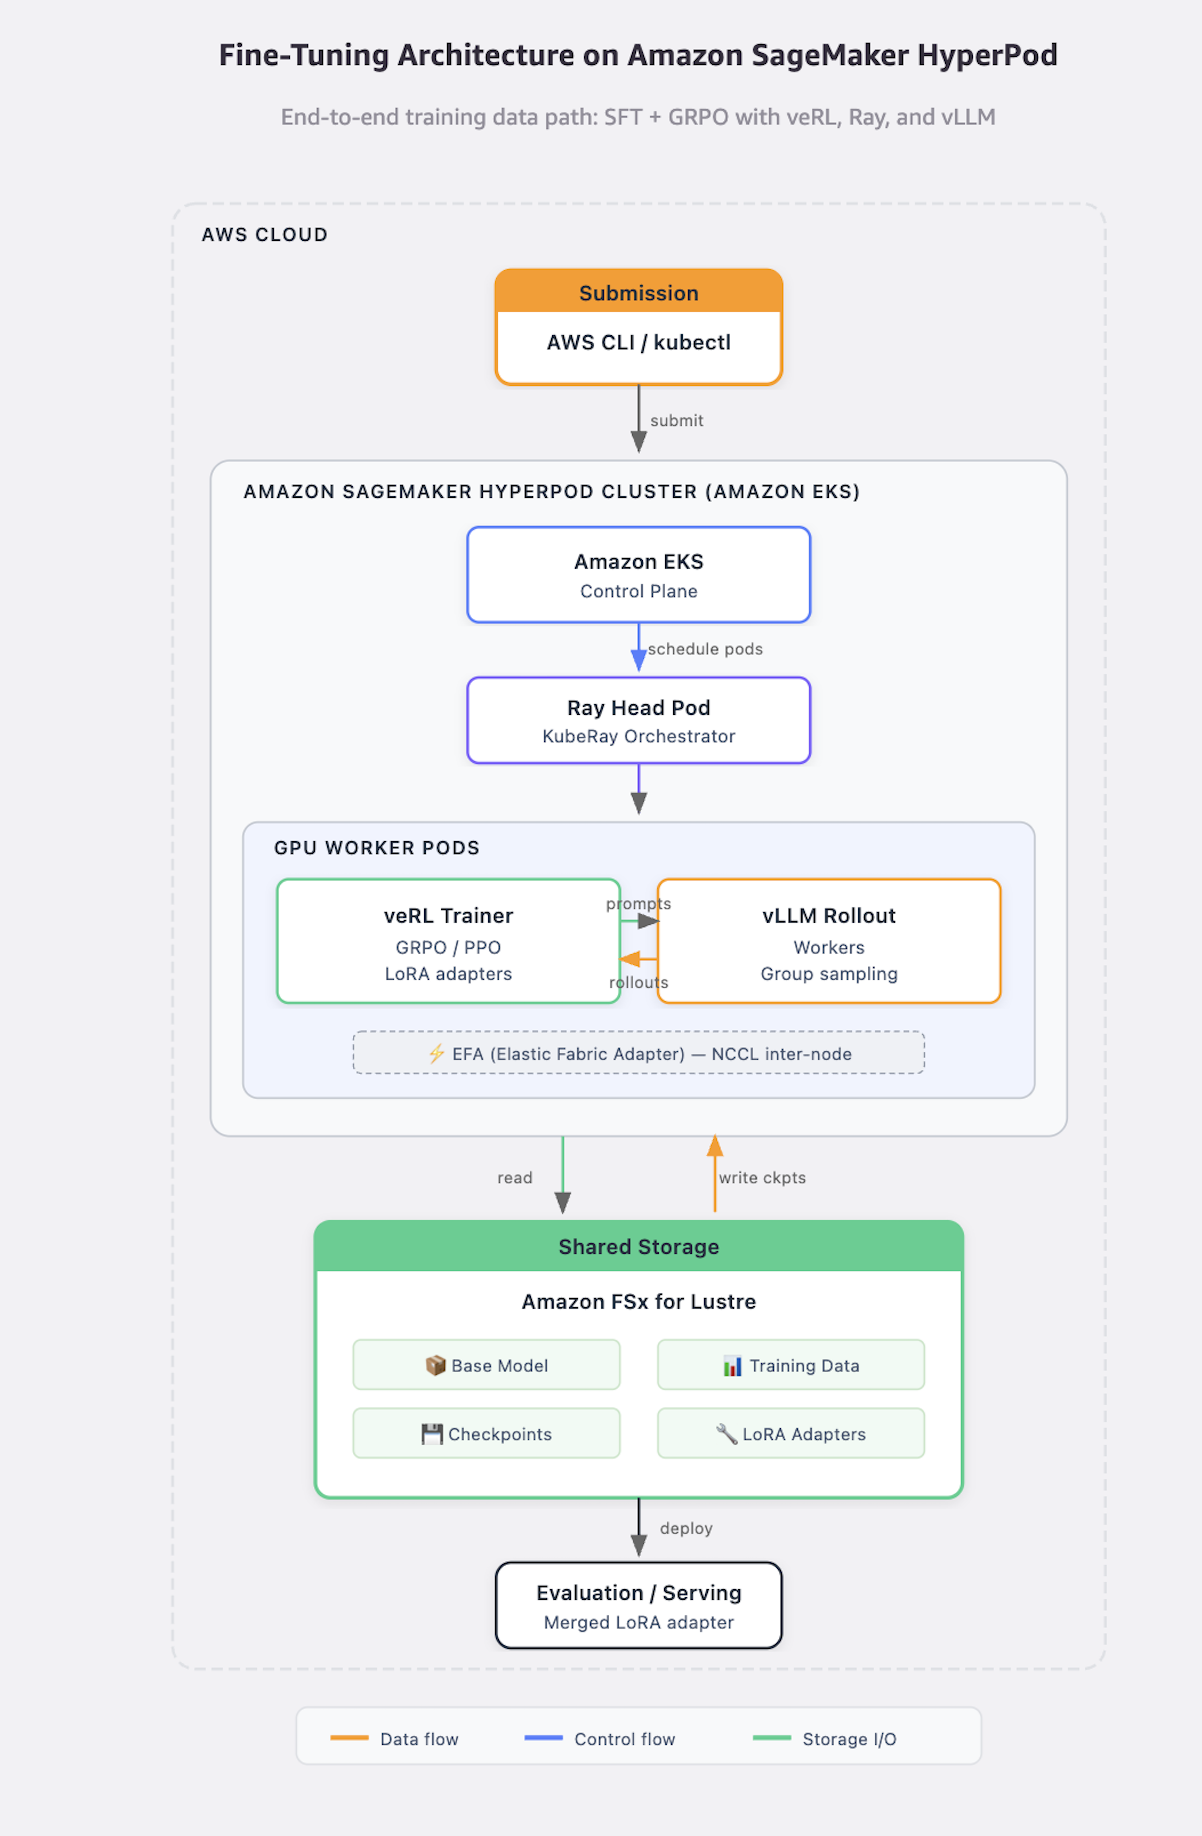
Onderzoekers hebben een open-source taalmodel onderworpen aan specifieke aanpassingen om de meertalige redeneervaardigheden te verbeteren. Hierbij zijn verschillende methoden vergeleken, waaronder gerichte training en reinforcement learning.
Bij het ontwikkelen en verfijnen van grote taalmodellen is het verbeteren van de redeneercapaciteiten in meerdere talen een belangrijk aandachtspunt. Door gebruik te maken van specifieke trainingsmethoden op gespecialiseerde computerinfrastructuren is de nauwkeurigheid van het model aanzienlijk toegenomen.
Verschillende trainingsstrategieën
Het onderzoek belicht de afweging tussen traditionele begeleide training en op beloning gebaseerde optimalisatietechnieken. Dergelijke technische stappen zijn kenmerkend voor de huidige ontwikkelingsfase van taalmodellen, waarin de focus verschuift van pure schaalvergroting naar gerichte prestatieverbetering en efficiëntie.
Deze samenvatting is gebaseerd op een origineel artikel van AWS Machine Learning. Lees het volledige, originele bericht bij de bron.
Lees het originele artikel