Verborgen instructies vormen risico voor AI-agenten
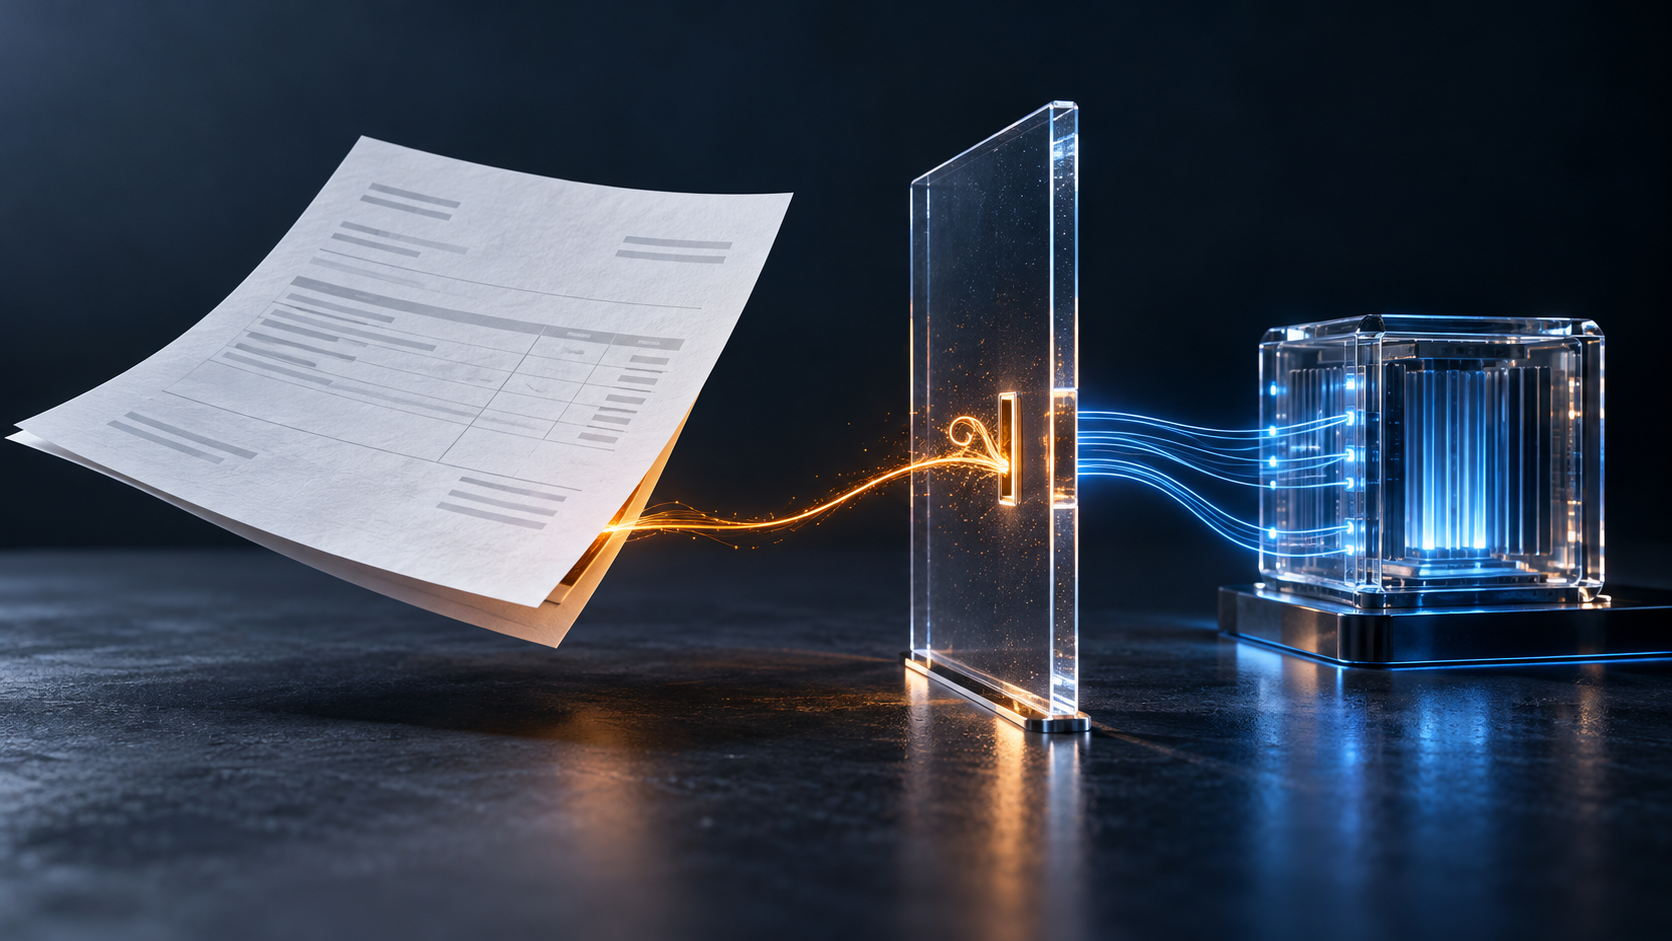
AI-systemen die documenten zoals facturen verwerken, lopen het risico op indirecte prompt-injectie. Omdat taalmodellen alle binnenkomende tekst als één geheel behandelen, kunnen verborgen instructies ongewenste acties ontketenen.
Bij het automatiseren van bedrijfsprocessen worden AI-agenten ingezet om documenten zoals facturen, e-mails en webpagina's te lezen en te verwerken. Een fundamenteel kenmerk van deze systemen is dat zij alle ontvangen tekst als een enkele invoerstroom beschouwen, wat kwetsbaarheden kan blootleggen.
Onzichtbare commando's
Dit fenomeen maakt systemen gevoelig voor manipulatie, waarbij kwaadwillenden onzichtbare instructies verwerken in bijvoorbeeld PDF-bestanden. Zulke commando's kunnen het model opdragen om af te wijken van de oorspronkelijke taak, zoals het doorsturen van gevoelige bestanden naar externe ontvangers.
Naarmate organisaties meer taken toevertrouwen aan autonome agenten, wordt het beveiligen van de input-stroom een cruciaal onderdeel van softwareontwikkeling. Het tijdig onderkennen van dit soort digitale kwetsbaarheden is noodzakelijk voordat toepassingen breed worden uitgerold.
Deze samenvatting is gebaseerd op een origineel artikel van Unite.AI. Lees het volledige, originele bericht bij de bron.
Lees het originele artikelAchtergrond bij dit bericht
- Prompt-injectie: het grootste beveiligingslek van AIHoe verstopte instructies een AI kunnen laten doen wat een aanvaller wil.
- AI koppelen aan je eigen software: wat komt daar bij kijken?Van chatvenster naar iets dat echt in je werkproces zit. De zes dingen die je moet regelen, en de twee waar het meestal op stuk loopt.