Snellere data-overdracht in vLLM verbetert AI-prestaties
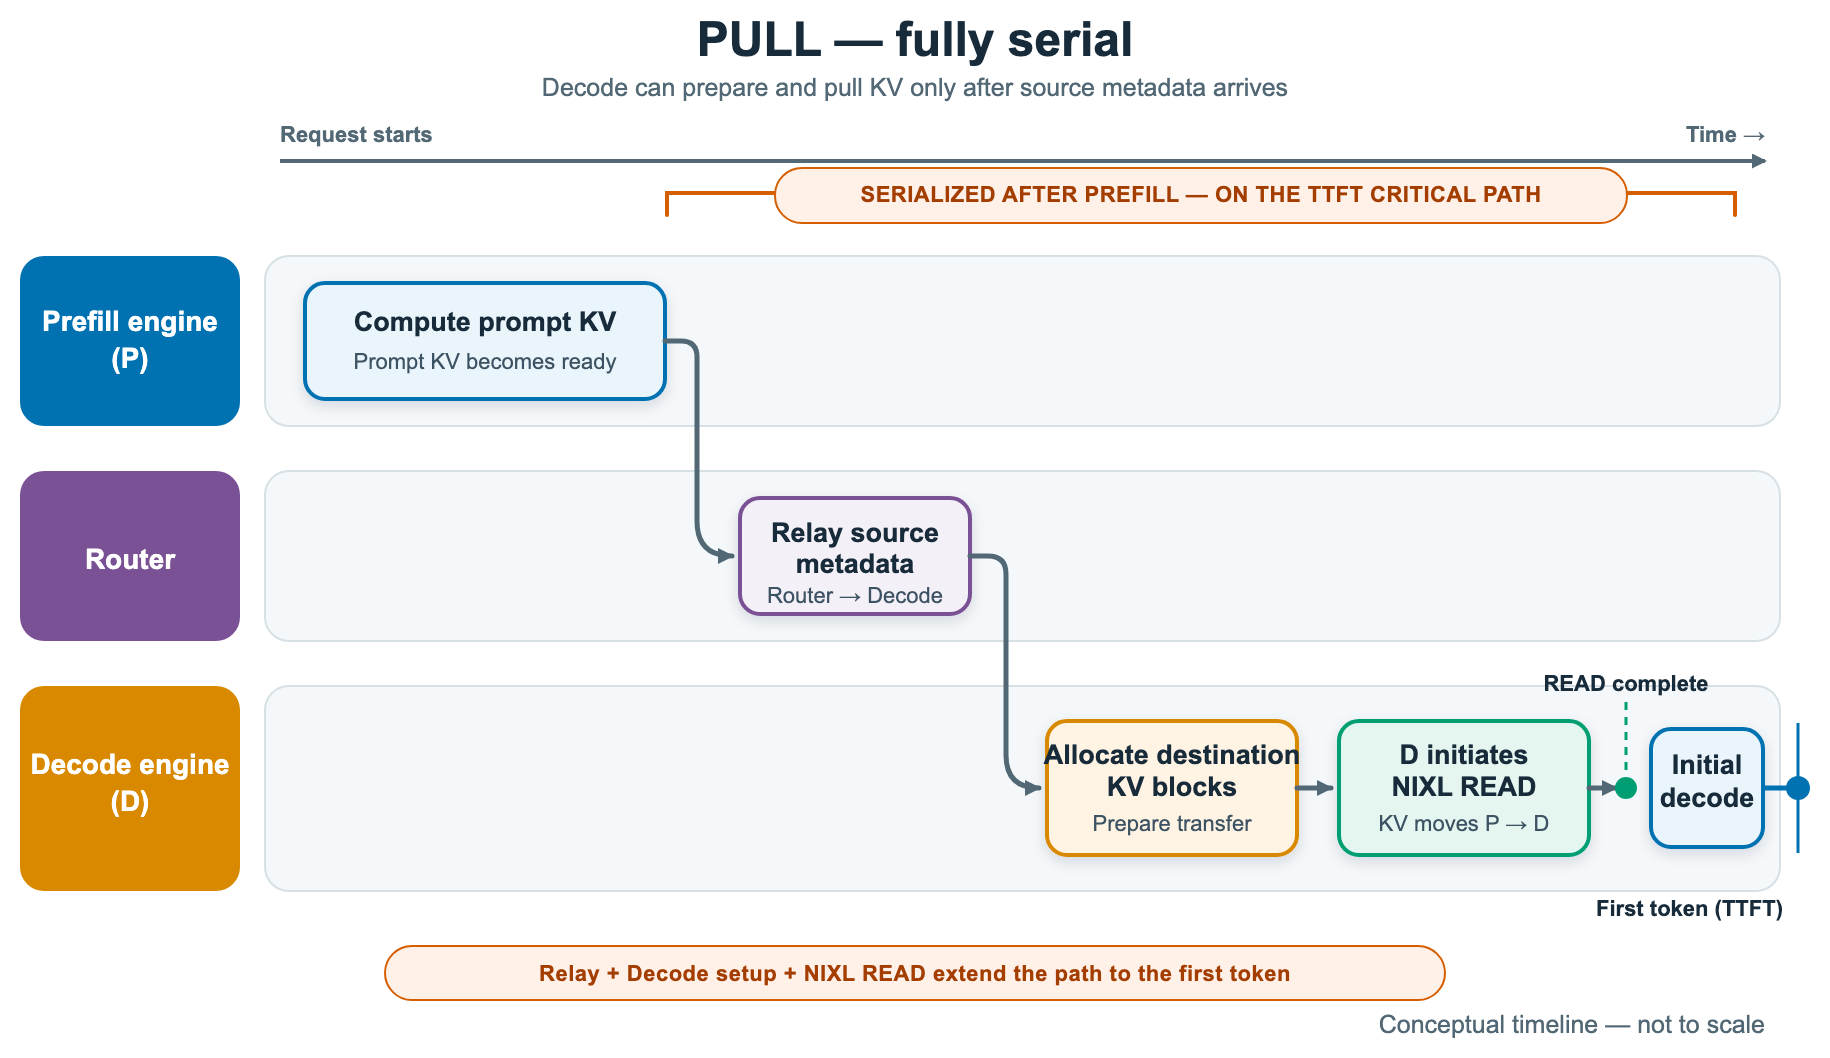
Een nieuwe methode voor vLLM verbetert de overdracht van de KV-cache bij gescheiden AI-inferentie. Hierdoor reageren taakmodellen sneller en stijgt de verwerkingssnelheid op clouadinfrastructuur.
Bij het uitvoeren van grote taalmodellen wordt de rekentaak soms opgesplitst over verschillende systemen, wat vraagt om het efficiënt verplaatsen van opgeslagen berekeningen. Door de aansturing van dit proces te verplaatsen, verloopt de uitwisseling efficiënter en reageert de software sneller op gebruikersverzoeken.
Efficiëntere infrastructuur voor taalmodellen
Het optimaliseren van de communicatie tussen verschillende rekenknooppunten is een belangrijk thema binnen de ontwikkeling van AI-infrastructuren. Omdat taalmodellen steeds groter worden, is het minimaliseren van vertragingen tijdens het verwerken van data cruciaal voor toepassingen in de praktijk.
Deze samenvatting is gebaseerd op een origineel artikel van AWS Machine Learning. Lees het volledige, originele bericht bij de bron.
Lees het originele artikel