Nvidia start productie van inferentie-chip en claimt hoge snelheden
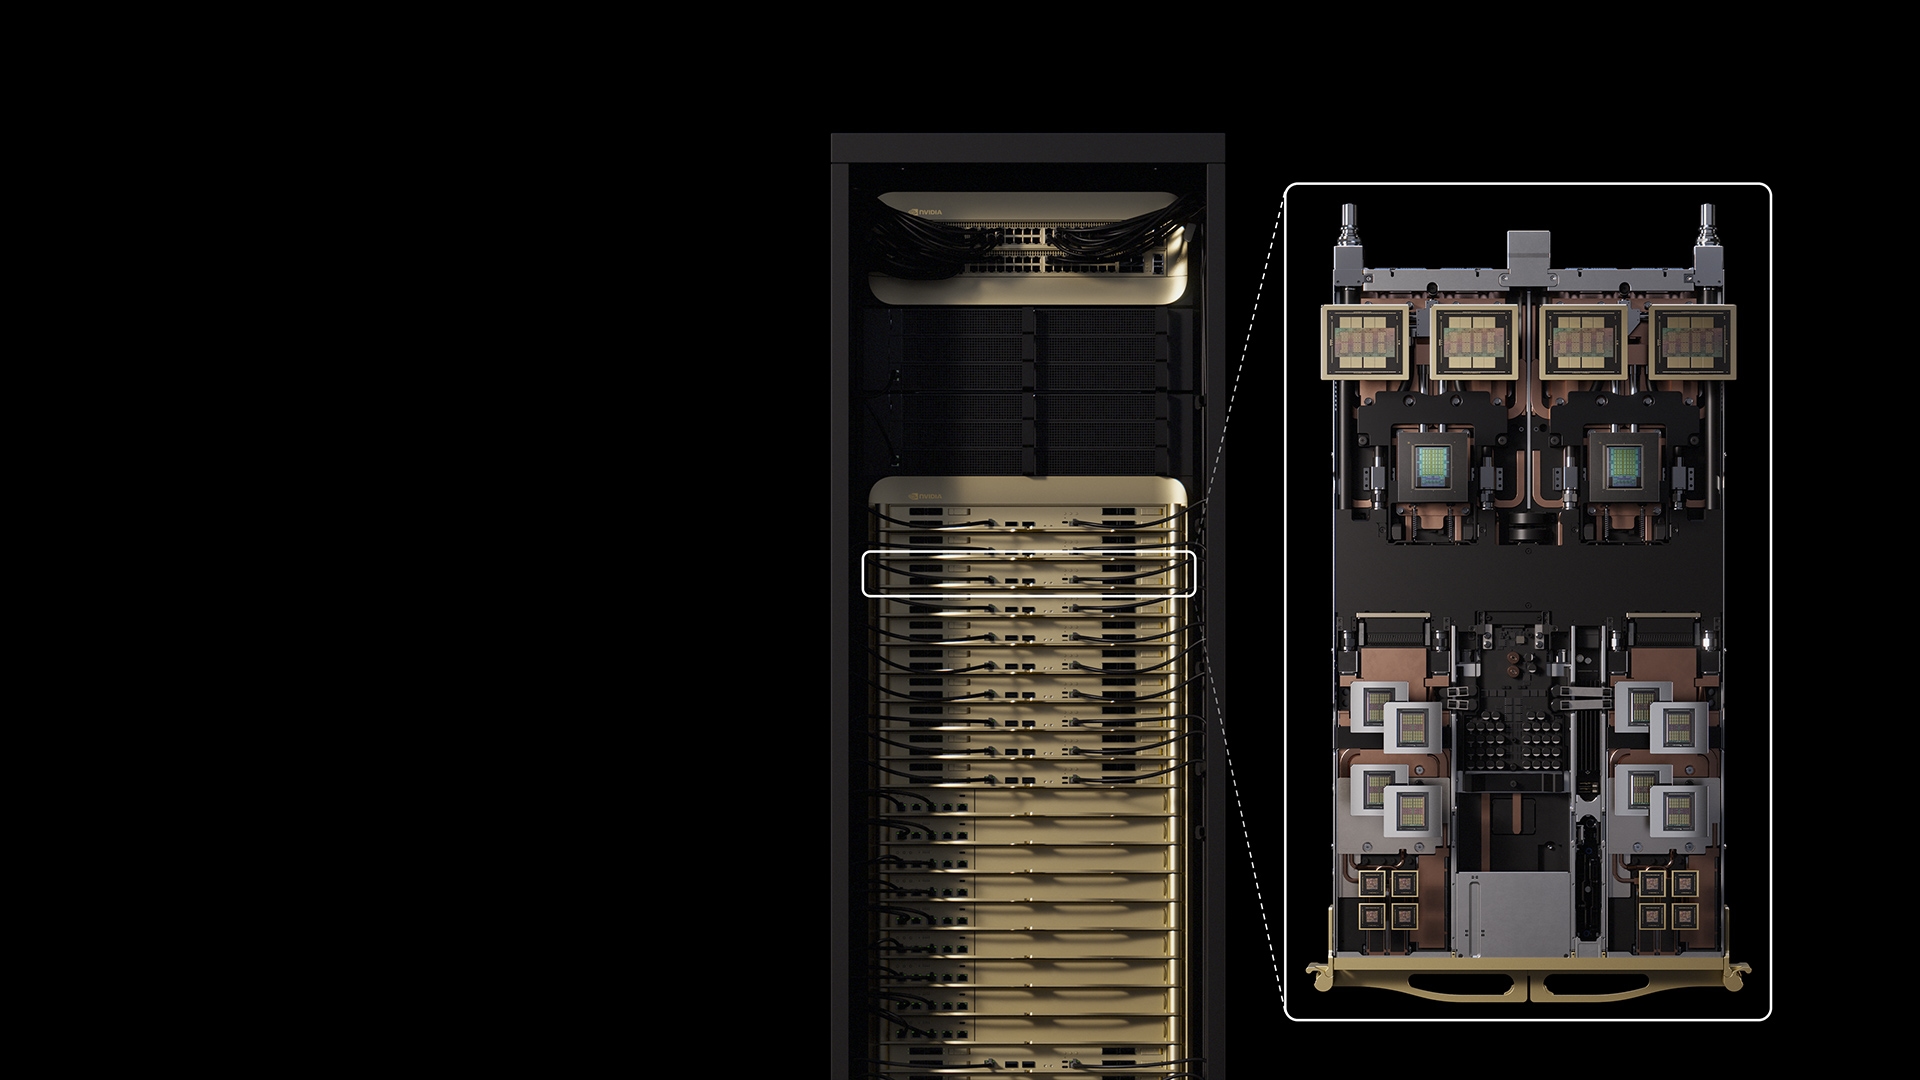
Nvidia brengt de Groq 3 LPX-chip in volle productie en claimt dat deze aanzienlijk sneller presteert dan systemen van concurrenten. Specialisten wijzen er echter op dat de achterliggende rekensom en de benodigde hardwarecomplexiteit complexer liggen dan de cijfers doen vermoeden.
De productie van de Groq 3 LPX-inferentiechip is door Nvidia in gang gezet. Volgens opgaves van het bedrijf haalt de chip hoge prestaties bij het verwerken van taalmodellen, waarmee de snelheid de capaciteit van alternatieve hardware ruimschoots overtreft. Vakgenoten benadrukken echter dat een vergelijking genuanceerder ligt door de randvoorwaarden.
Om de geclaimde prestaties te bereiken is namelijk een aanzienlijke hoeveelheid hardware nodig, in tegenstelling tot alternatieve systemen die met minder middelen volstaan. Dit roept vragen op over de schaalbaarheid van de gebruikte architectuur in combinatie met geavanceerde modellen. Binnen de halfgeleidersector is de efficiëntie van inferentie-chips een belangrijk strijdtoneel geworden, nu de vraag naar rekenkracht voor kunstmatige intelligentie onverminderd hoog blijft.
Deze samenvatting is gebaseerd op een origineel artikel van The Decoder. Lees het volledige, originele bericht bij de bron.
Lees het originele artikel