Kostenbesparing bij RAG-toepassingen op Amazon Bedrock
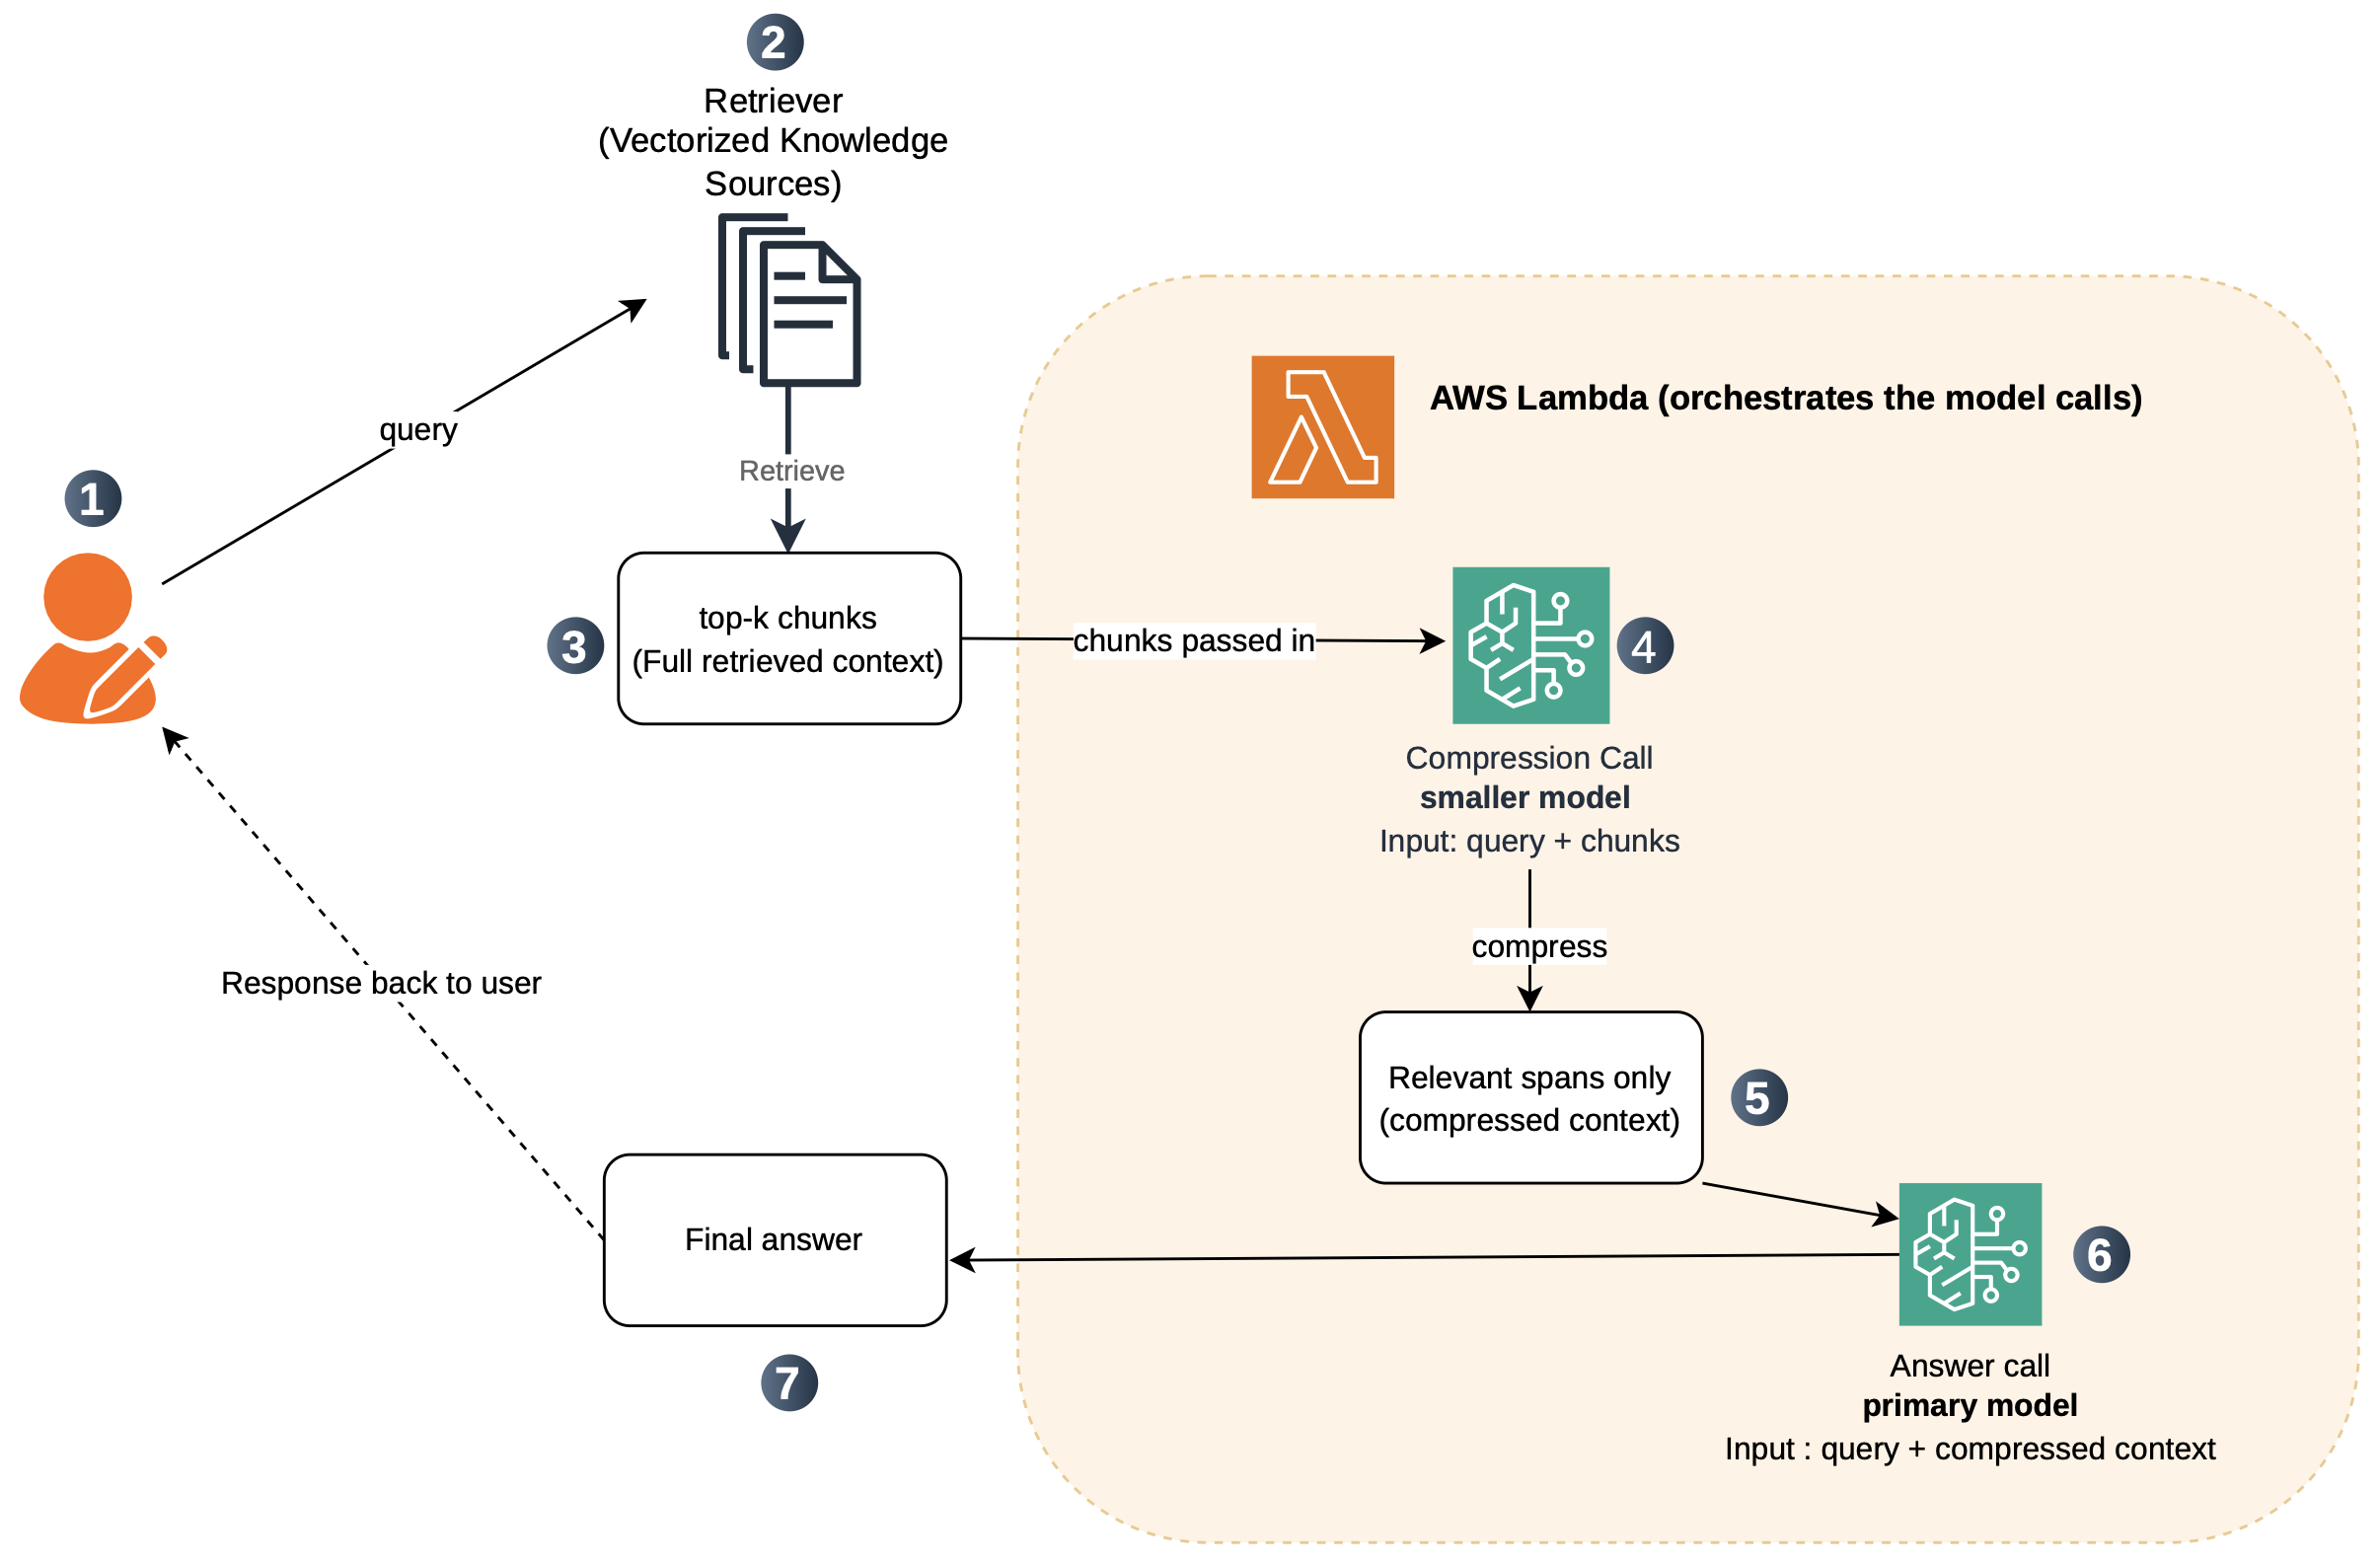
Amazon Web Services deert een methode om de kosten van Retrieval Augmented Generation te verlagen door middel van gerichte contextcompressie. Een kleiner model filtert opgehaalde tekstfragmenten voordat het primaire model antwoord geeft.
Bij het grootschalig inzetten van taalmodellen via Retrieval Augmented Generation vormen de verwerkingskosten van inputtokens vaak een aanzienlijke kostenpost. Om dit aan te pakken is er een methode ontwikkeld waarbij een kleiner model de opgehaalde documenten vooraf filtert op basis van de gestelde vraag, voordat het hoofdmodel hiermee aan de slag gaat.
Deze optimalisatie zorgt ervoor dat er minder overbodige informatie wordt meegestuurd naar het primaire taalmodel, wat direct leidt tot een reductie in het aantal benodigde tokens en daarmee de operationele kosten. Dit past in de bredere ontwikkeling binnen de kunstmatige intelligentie om grootschalige taalmodellen efficiënter en betaalbaarder te maken voor bedrijfsmatige toepassingen.
Deze samenvatting is gebaseerd op een origineel artikel van AWS Machine Learning. Lees het volledige, originele bericht bij de bron.
Lees het originele artikel