Hoe visie-taalmodellen beelden en taal met elkaar verbinden
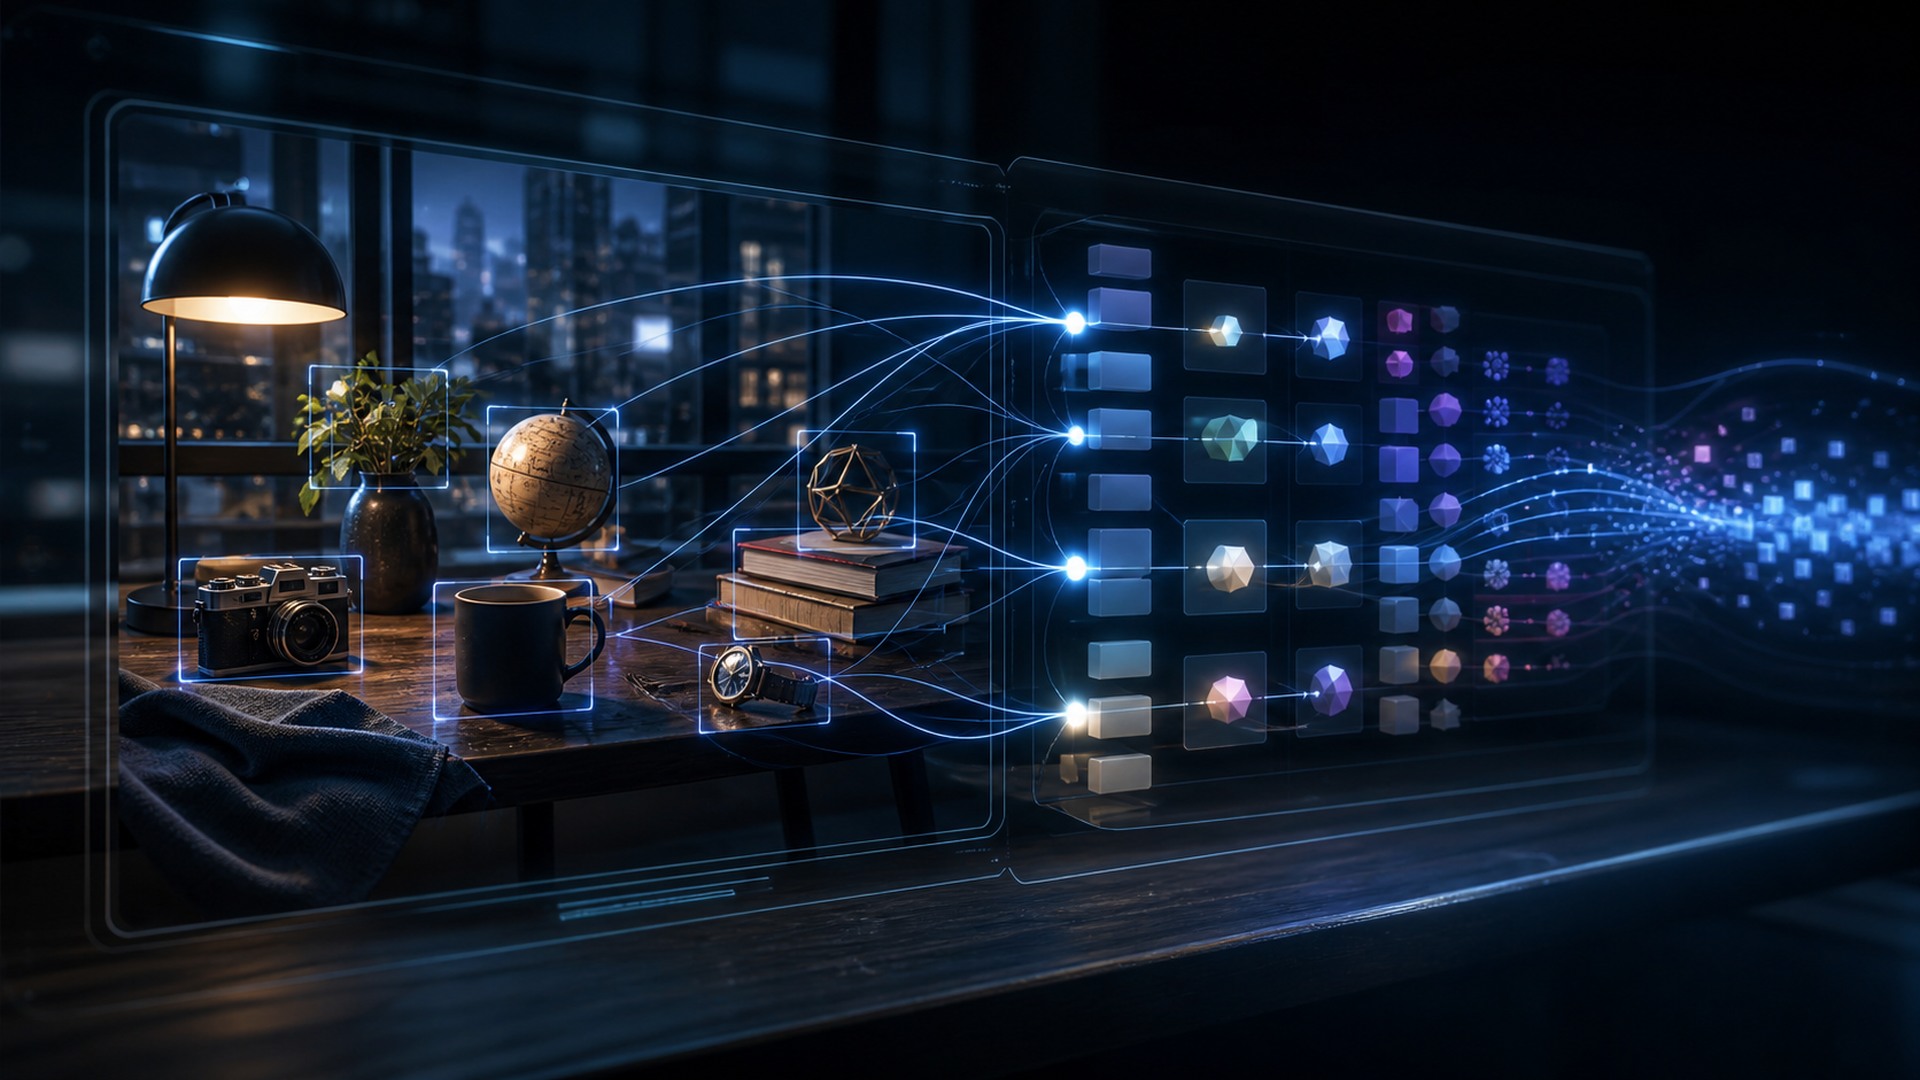
Visie-taalmodellen combineren visuele informatie met taalverwerking. Hierdoor kunnen computers afbeeldingen beschrijven, doorzoeken en analyseren aan de hand van tekst.
Visie-taalmodellen vormen een categorie binnen de kunstmatige intelligentie die visuele kenmerken koppelt aan tekstuele data. Dit stelt systemen in staat om afbeeldingen te interpreteren en er via woorden over te redeneren.
De techniek achter multimodale systemen
Het koppelen van beeld en taal is een belangrijke stap in de ontwikkeling van multimodale AI. Waar vroege systemen strikt gescheiden werkten met óf tekst óf beeld, integreren deze modellen beide modaliteiten. Dit maakt geavanceerde toepassingen mogelijk, zoals het automatisch genereren van beschrijvingen bij foto's of het beantwoorden van vragen over visuele content.
Deze samenvatting is gebaseerd op een origineel artikel van Unite.AI. Lees het volledige, originele bericht bij de bron.
Lees het originele artikel