Google-onderzoek: het ophalen van kennis is de zwakke schakel, niet het opslaan
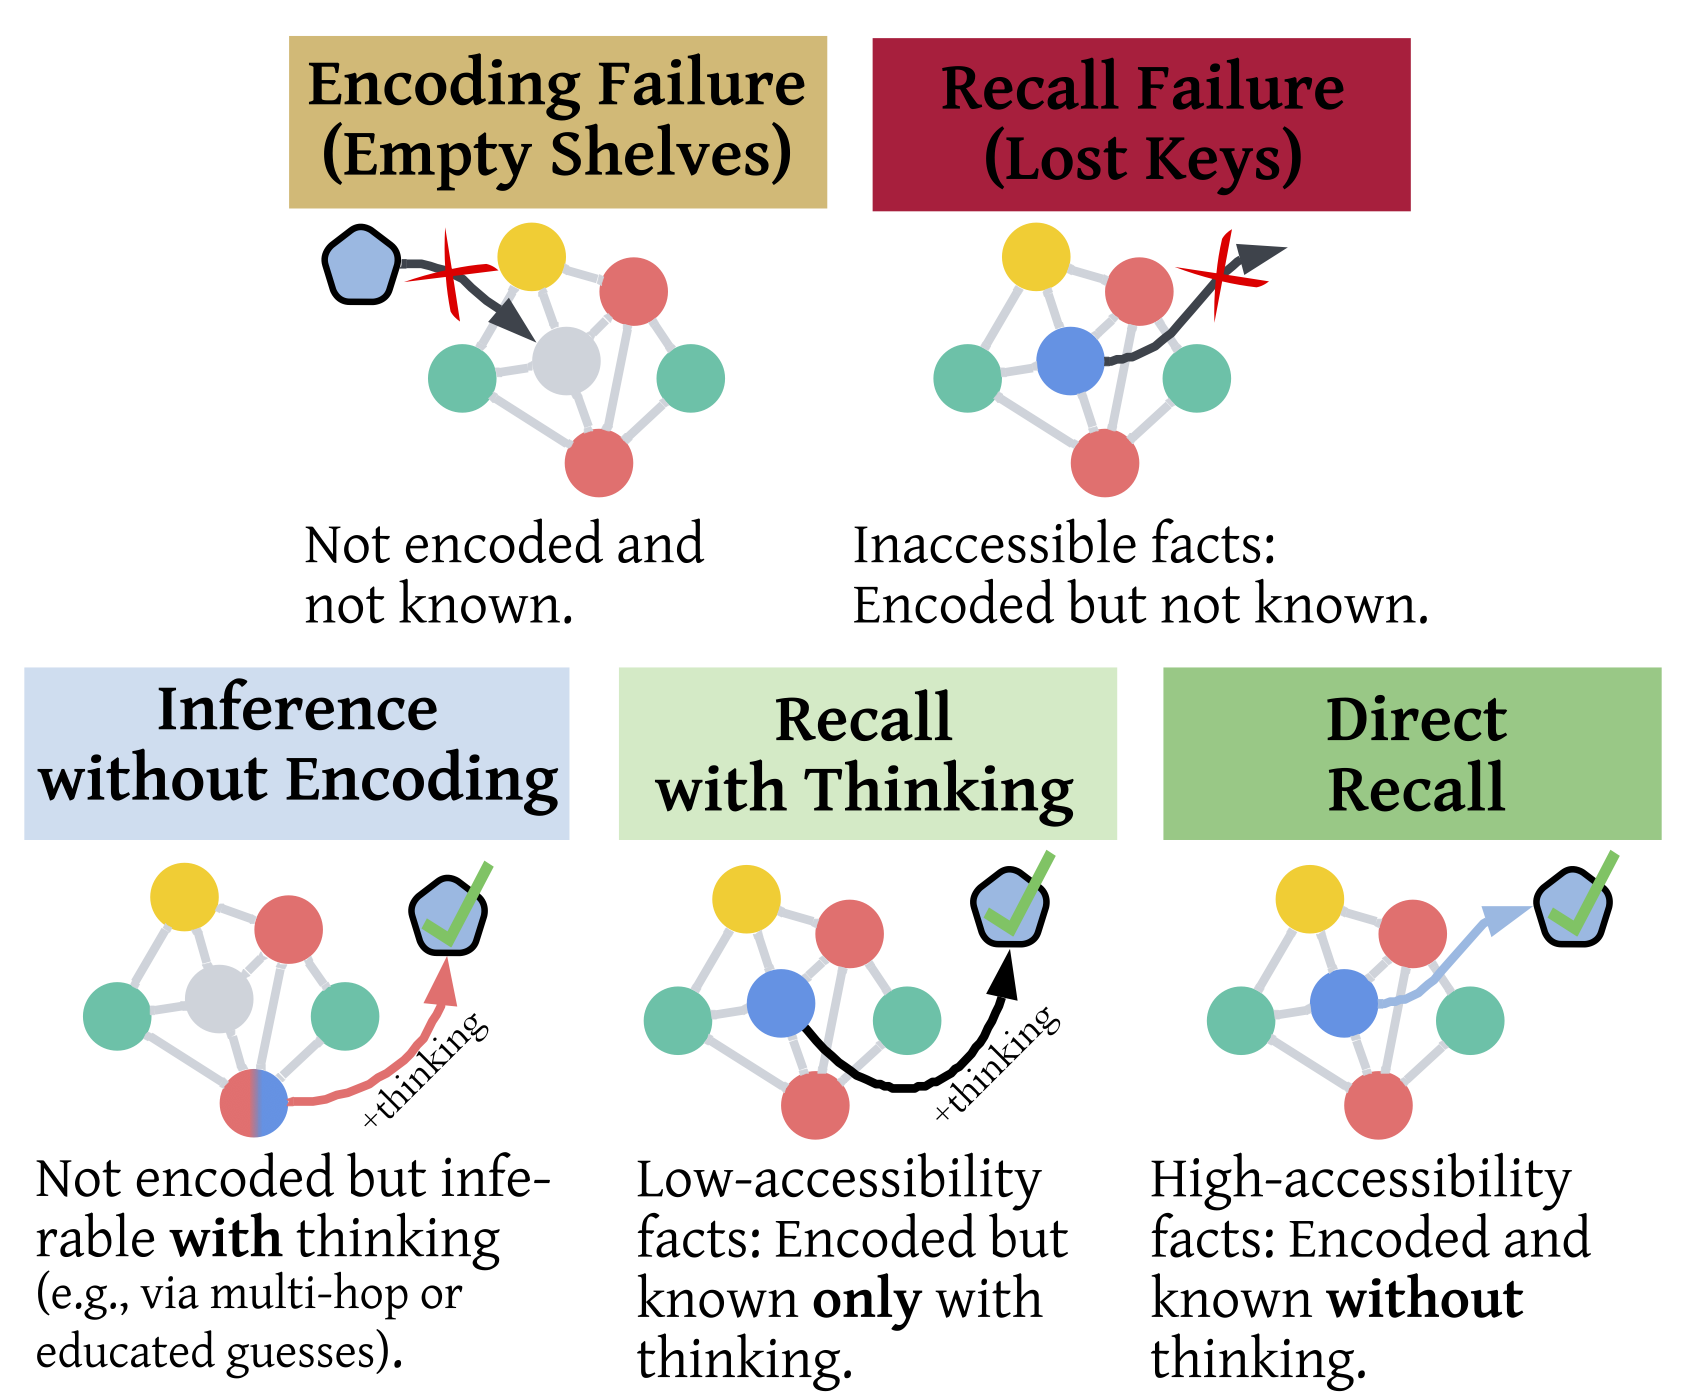
Onderzoekers van Google concluderen dat taalmodellen feiten vaak wel bevatten maar ze niet weten terug te vinden. Het probleem lijkt daarmee minder op lege schappen en meer op zoekgeraakte sleutels. Die bevinding heeft praktische gevolgen: modellen groter maken helpt minder dan slimmer ophalen, wat het belang van technieken als RAG onderstreept.
Uit een publicatie van Google Research blijkt dat moderne taalmodellen moeite hebben met het reproduceren van informatie die ze tijdens de training al hebben verwerkt. Het knelpunt bij deze systemen zit doorgaans niet in het onthouden van feiten, maar in het correct lokaliseren en opdiepen van die gegevens wanneer een gebruiker erom vraagt.
Gerichter zoeken in plaats van groter bouwen
Deze ontdekking verandert de manier waarop naar de ontwikkeling van kunstmatige intelligentie wordt gekeken. Waar lang werd aangenomen dat systemen vooral groter en complexer moesten worden om slimmer te presteren, wijst dit onderzoek uit dat de focus beter kan liggen op efficiëntere zoekmethoden.
De bevindingen sluiten aan bij de opkomst van technieken zoals Retrieval-Augmented Generation, afgekort als RAG. Bij deze benadering krijgt een model hulp van externe zoekmechanismen om gericht informatie op te halen voor het een antwoord formuleert. Dat helpt om de betrouwbaarheid van de output te vergroten zonder dat het onderliggende taalmodel zelf onevenredig hoeft te groeien.
Deze samenvatting is gebaseerd op een origineel artikel van Google Research. Lees het volledige, originele bericht bij de bron.
Lees het originele artikel