Efficiënter werken met prompt caching in Amazon Bedrock
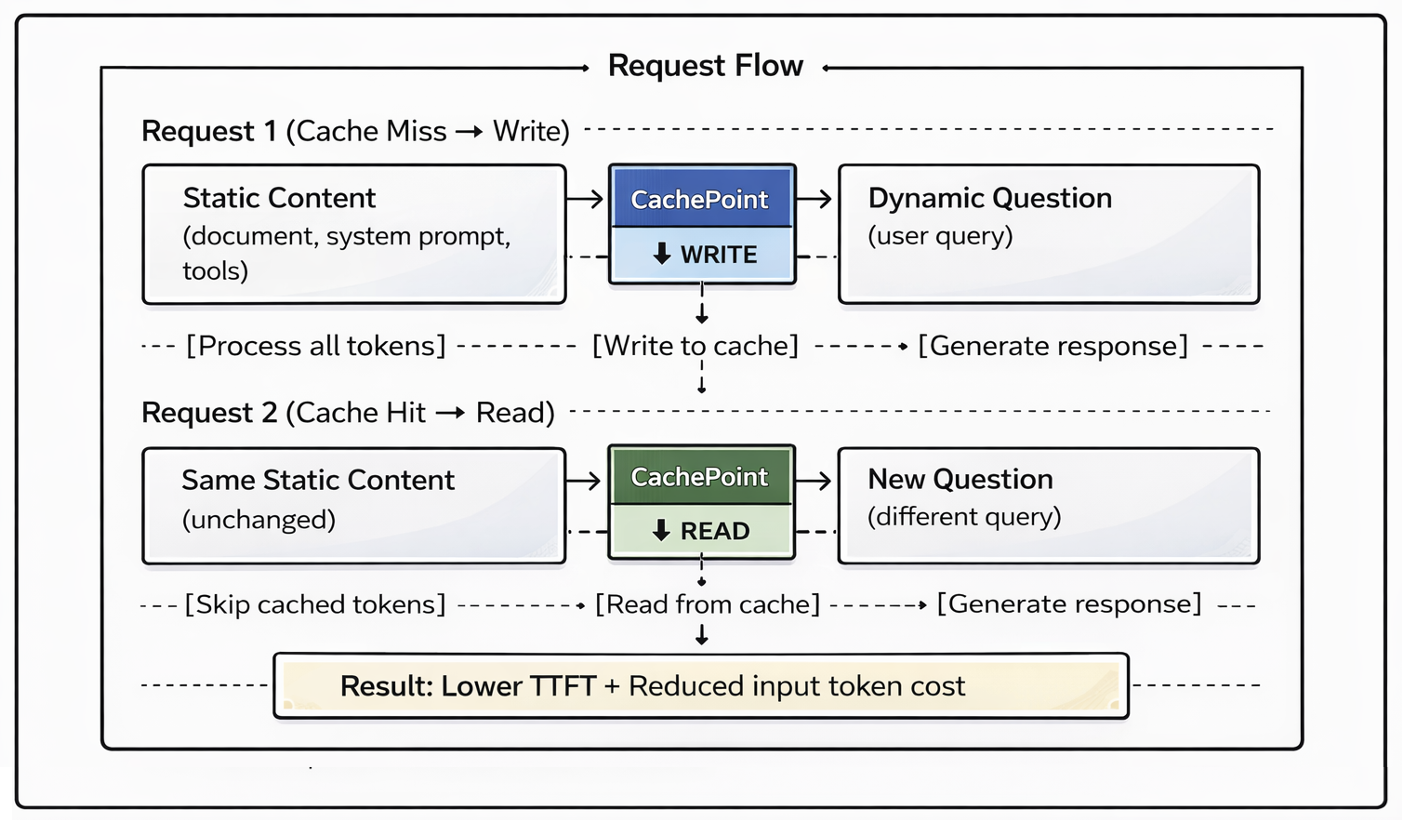
Amazon Web Services belicht diverse scenario's voor het toepassen van prompt caching binnen de Bedrock-omgeving. Deze techniek helpt om de verwerkingstijd en kosten van veelgebruikte context in taalmodellen te reduceren.
Het herhaaldelijk versturen van dezelfde context naar fundamentele modellen kan binnen cloudomgevingen aanzienlijke kosten en vertragingen met zich meebrengen. Door gebruik te maken van cachingmechanismen is het mogelijk om vaste instructies of achtergrondinformatie tijdelijk op te slaan, waardoor systemen minder rekenkracht nodig hebben voor volgende verzoeken. Er zijn verschillende praktische scenario's uitgewerkt om deze functionaliteit te benutten binnen applicaties.
Het optimaliseren van de interactie met grote taalmodellen is een belangrijk aandachtspunt voor ontwikkelaars die betrouwbare en betaalbare AI-toepassingen willen bouwen. Caching helpt niet alleen om de operationele uitgaven te beheersen, maar draagt ook bij aan een snellere respons bij toepassingen waarin dezelfde systeeminformatie of documentatie telkens opnieuw wordt geraadpleegd.
Deze samenvatting is gebaseerd op een origineel artikel van AWS Machine Learning. Lees het volledige, originele bericht bij de bron.
Lees het originele artikel