De rol van chunking bij het verbeteren van RAG-systemen
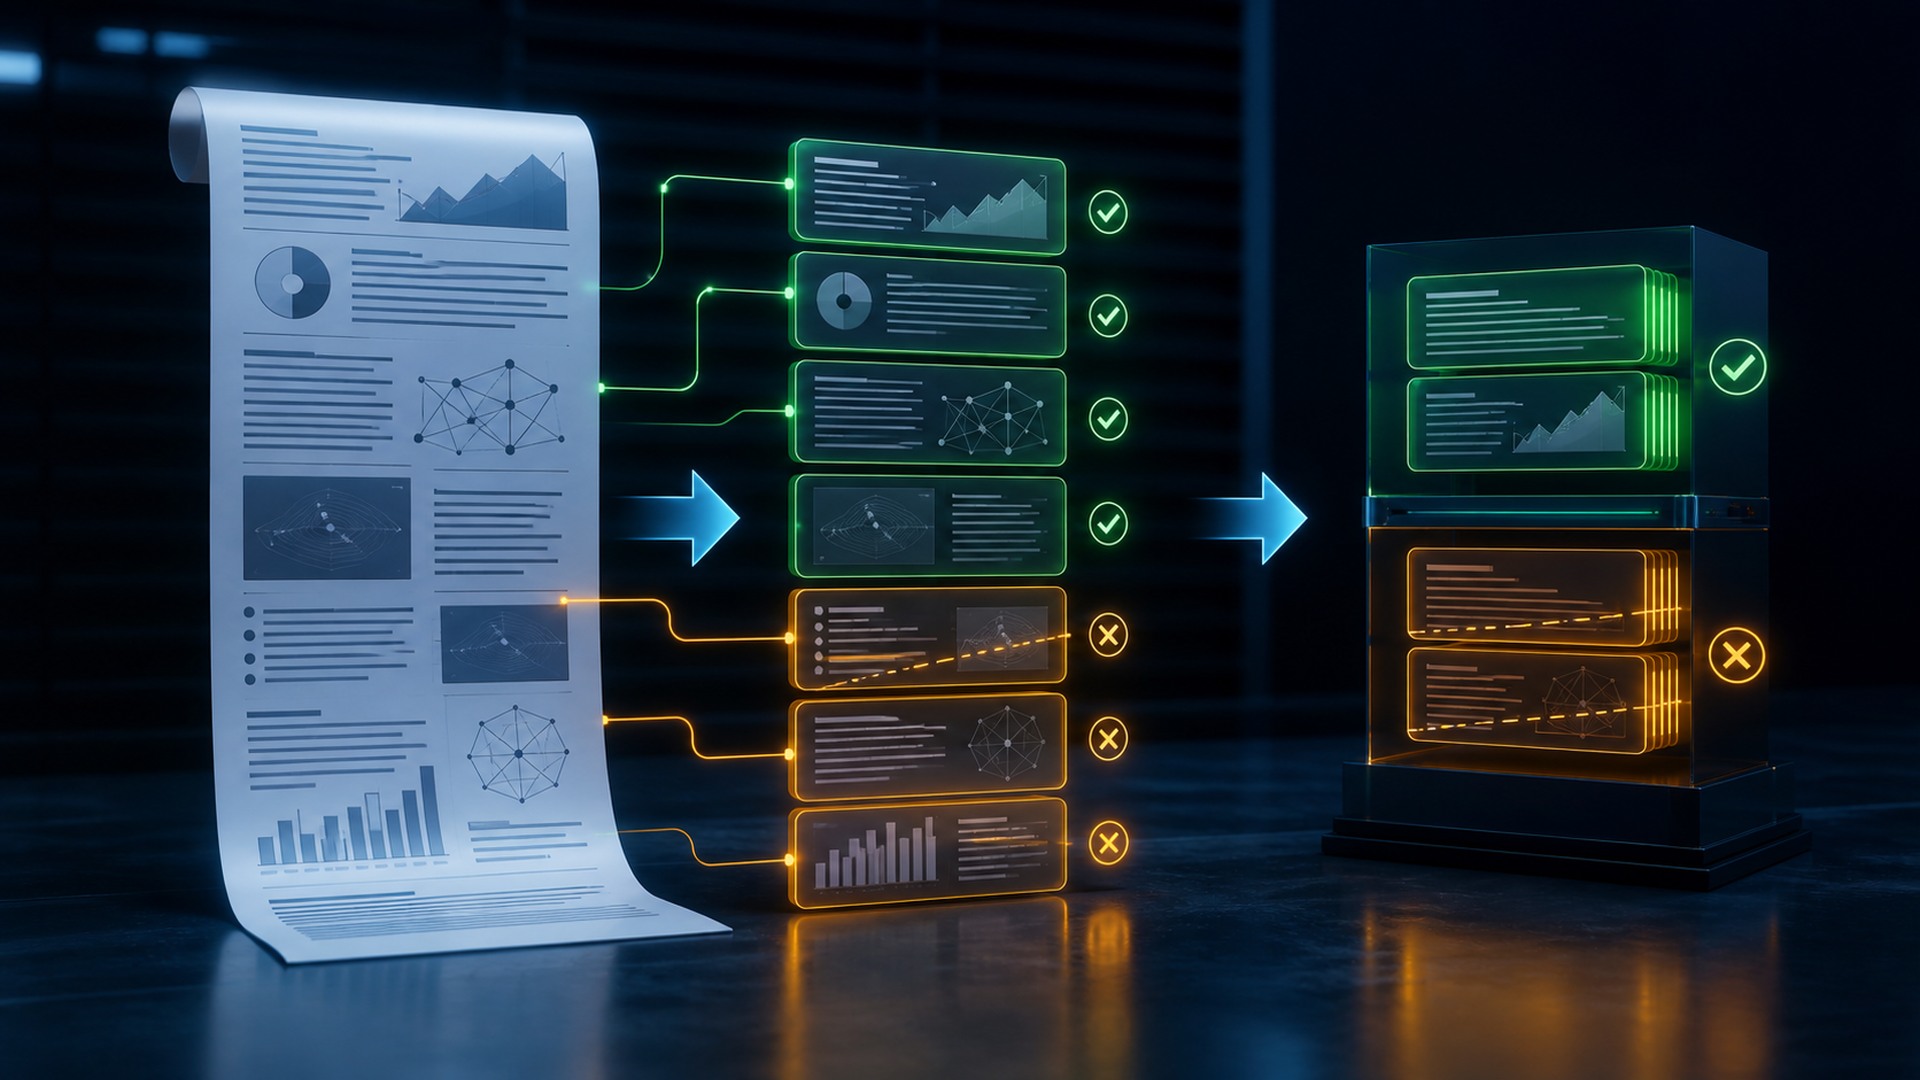
Documentverdeling, ook wel chunking genoemd, is een fundamenteel onderdeel binnen Retrieval-Augmented Generation. De manier waarop bronmateriaal in opvraagbare eenheden wordt gesplitst, bepaalt in hoge mate welke informatie een systeem kan terugvinden en presenteren.
Binnen de ontwikkeling van taalmodellen en zoekarchitecturen vormt het opdelen van bronteksten een cruciale stap. Bij deze methode worden grote lappen tekst in kleinere brokken geknipt voordat ze worden opgeslagen en doorzocht. De grenzen die hierbij gehanteerd worden en de bijbehorende metadata zijn bepalend voor de effectiviteit waarmee relevante informatie later boven water komt.
Invloed op de kwaliteit van antwoorden
Wanneer documenten onzorgvuldig worden opgeknipt, kan context verloren gaan of juist te breed worden getrokken. Dit heeft direct invloed op de juistheid en volledigheid van de antwoorden die een Retrieval-Augmented Generation-systeem genereert. Ontwikkelaars moeten daarom zorgvuldig afwegen hoe groot de tekstblokken moeten zijn en hoe de bijbehorende metadata wordt ingericht.
Het optimaliseren van dit soort datastromen is een belangrijk aandachtspunt bij het betrouwbaarder maken van AI-toepassingen in bedrijfsomgevingen. Terwijl de focus vaak ligt op de intelligentie van het model zelf, hangt het succes van zakelijke toepassingen in de praktijk sterk af van een goede datavoorbereiding en infrastructuur aan de achterkant.
Deze samenvatting is gebaseerd op een origineel artikel van Unite.AI. Lees het volledige, originele bericht bij de bron.
Lees het originele artikel