Benchmarks tonen prestaties van kleine taalmodellen op SageMaker AI
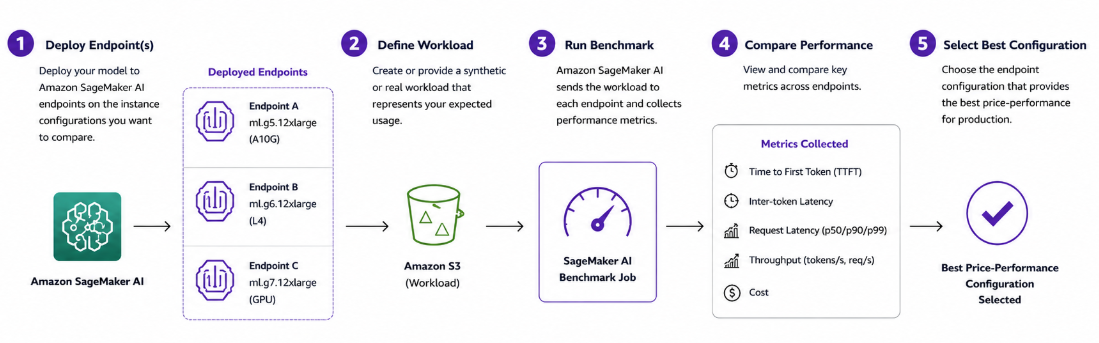
Er is een vergelijkende studie uitgevoerd naar het draaien van compacte taalmodellen op verschillende generaties grafische processoren. De focus lag hierbij op snelheid en operationele kosten.
Op het platform Amazon SageMaker AI zijn prestatietests uitgevoerd met specifieke open-weights modellen. Daarbij zijn verschillende typen hardware met elkaar vergeleken om te zien hoe efficiënt ze omgaan met de verwerking van taalmodellen.
De opkomst van compacte taalmodellen
De markt voor kunstmatige intelligentie richt zich steeds vaker op kleinere modellen die minder rekenkracht vereisen dan de allergrootste systemen. Deze compacte varianten bieden voor veel bedrijven een aantrekkelijk alternatief vanwege lagere operationele kosten en snellere reactietijden.
De keuze voor de juiste hardware is cruciaal voor organisaties die real-time toepassingen willen draaien zonder dat de kosten onbeheersbaar stijgen. Door verschillende generaties chips te testen, krijgen beheerders meer inzicht in de optimale balans tussen prestaties en investering.
Deze samenvatting is gebaseerd op een origineel artikel van AWS Machine Learning. Lees het volledige, originele bericht bij de bron.
Lees het originele artikel