Automatisering van metadata-harmonisatie met kunstmatige intelligentie
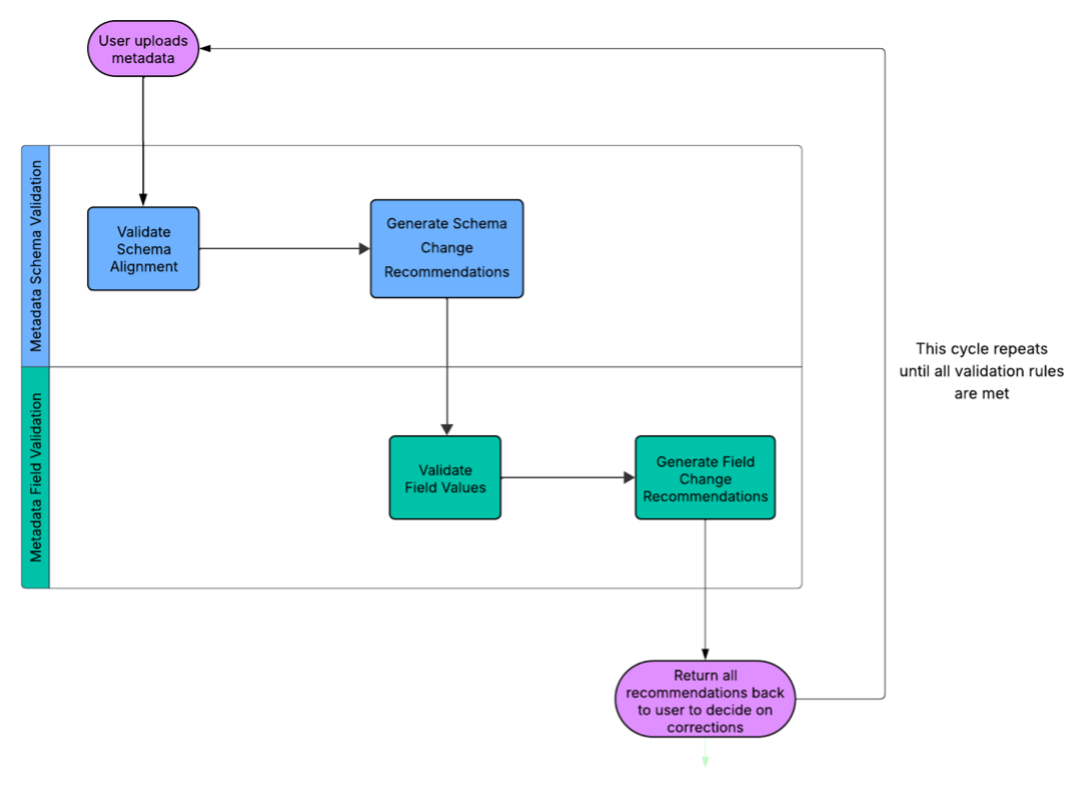
Het standaardiseren en corrigeren van datasets gebeurt nog grotendeels handmatig, maar systemen bieden hier steeds vaker uitkomst. Nieuwe methoden combineren menselijke controle met autonome workflows om data beter bruikbaar te maken.
Het op elkaar afstemmen van labels, identifiers en formaten in grote datasets is traditioneel een intensieve handmatige taak. Door de inzet van slimme algoritmen kunnen organisaties dit proces efficiënter inrichten en gegevens sneller toegankelijk maken voor verdere analyses.
Verschillende benaderingen voor datakwaliteit
In de praktijk wordt onderscheid gemaakt tussen systemen waarbij mensen de eindbeslissing controleren en workflows die volledig zelfstandig opereren. Beide methoden vereisen zorgvuldige governance om de betrouwbaarheid van de data in productieomgevingen te waarborgen.
Het harmoniseren van metadata vormt een fundamentele stap bij het trainen en inzetten van moderne modellen. Zonder goed georganiseerde gegevens is het voor organisaties immers lastig om betrouwbare resultaten te behalen met geavanceerde informatiesystemen.
Deze samenvatting is gebaseerd op een origineel artikel van AWS Machine Learning. Lees het volledige, originele bericht bij de bron.
Lees het originele artikel